System · das Netz, es verbindet
Nexus
Die Schicht, auf der alles läuft.
Nexus ist die selbst gehostete Plattform, die die Systeme und ihre Stores baut, verbindet und betreibt, auf Ihrer eigenen Infrastruktur in der EU. Im Alltag bedient sie ein Assistent über eine protokollierte Steuerfläche; alles mit realer Wirkung verbraucht eine einmalige Freigabe durch einen Menschen. Nexus ist das Fundament, auf dem das Produkt steht, keine Funktion davon.
Die InfrastrukturDer Ablauf
- Verbindet jedes System und jeden Store über ein privates Mesh.
- Selbst gehostet: Ihre Daten verlassen nie Ihre Infrastruktur.
- Automatisches TLS, Deploys ohne Ausfallzeit und eine einmalige Freigabe durch einen Menschen für jede externe Aktion.
Im Zusammenspiel
Betreibt und verbindet Cortex, Lens, Atlas, Thalamus, Larynx, Pharynx und die Stores.
Unter der Haube
Ein Assistent am Steuer. Ein Mensch bei den Freigaben.
Nexus ist unsere eigene Deployment-Plattform: eine kontrollierte Engine, die aus git baut, jeder App automatisches TLS vorschaltet, Zugangsdaten zwischen Systemen verdrahtet und die ganze Flotte auf einem kleinen Cluster aus Maschinen betreibt. Ungewöhnlich ist, wer sie bedient. Ein Assistent erledigt den Alltag über dieselbe protokollierte Steuerfläche, die auch ein Mensch nutzt, und alles mit realer Wirkung bleibt hinter einer einmaligen Freigabe durch einen Menschen.
Die Konsole · mit Demodaten gezeigt
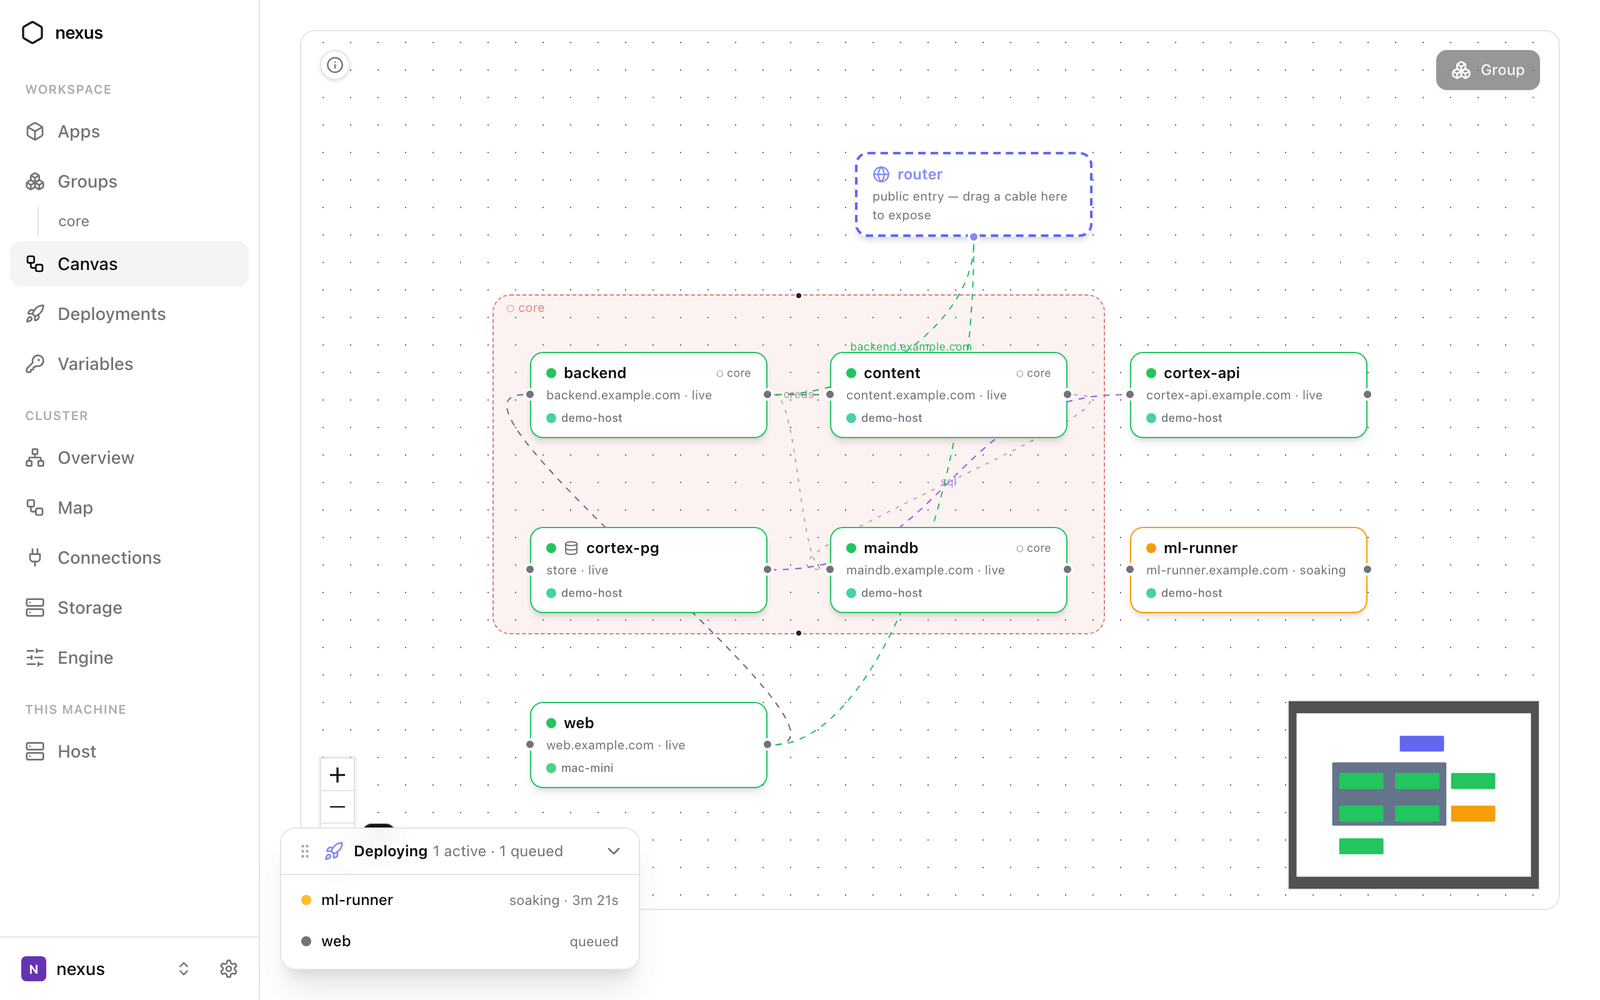
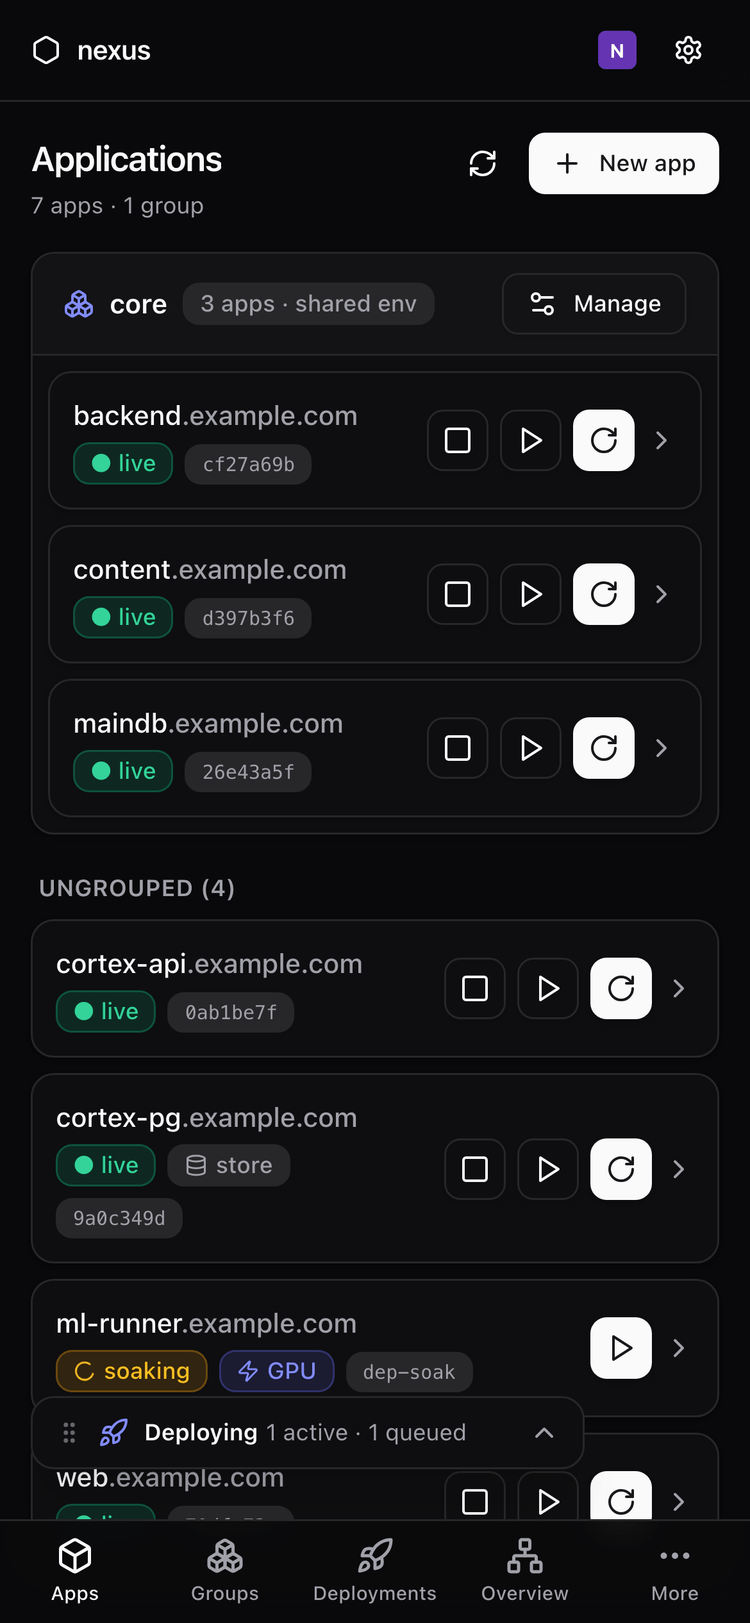
Apps sind Knoten auf einer Arbeitsfläche. Ein Kabel zum Router macht eine App öffentlich erreichbar, eine gestrichelte Hülle ist eine Gruppe mit gemeinsamen Zugangsdaten, und die Warteschlange unten ist ein Release im Probelauf vor der Umschaltung. Rechts dieselbe Flotte im Handyformat.
Ein Deploy, von Anfang bis Ende
Ein neues Release wird isoliert gebaut, muss seinen Health-Check bestehen und läuft dann eine Probezeit lang verdeckt mit, während der Produktions-Traffic beim alten bleibt. Nur ein Release, das gesund bleibt, wird umgeschaltet; eines, das scheitert, ersetzt nie, was live ist. Zustandsbehaftete Apps und Stores werden erst gestoppt, dann gestartet, mit automatischem Rollback.
Wer was darf
Lesezugriffe laufen sofort. Konfigurationsänderungen fragen einmal nach. Deploys, Veröffentlichungen und Löschungen sind externe Aktionen: Jede verbraucht eine Freigabe, die ein menschlicher Operator erteilt, und der Assistent kann sich keine selbst erteilen. Die Engine erzwingt die Ablehnung, nicht ein Prompt, der höflich darum bittet.
Eine Sitzung aus unserer eigenen Flotte · Namen geändert
„Die Laufzeit-Logs aller acht Dienste durchgehen und alles finden, was unnötig Lärm macht.“
Liest acht Log-Enden in einem Durchgang, Secrets bereits geschwärzt. Findet einen Worker, der bei leeren Warteschlangen alle fünf Sekunden einen Socket-Timeout wirft.
Korrigiert den Timeout der Warteschlange, ergänzt einen Regressionstest, committet.
Beantragt ein Deploy. Das ist eine externe Aktion, also braucht es eine Freigabe.
Erteilt eine einmalige Deploy-Freigabe für den Worker.
Build → Health-Check → verdeckter Probelauf → Umschaltung. Rollback durchgehend scharf.
Worker live. Logs ruhig.
Neun Minuten von der Frage bis zu ruhigen Logs. Die einzigen menschlichen Handgriffe waren die Frage und die Freigabe.
Die übrigen Systeme
Dies ist ein Teil eines Systems, das für ein einziges Versprechen gebaut ist: Jede Antwort ist belegt und rechtebewusst, oder sie kommt gar nicht.